नेचुरल लैंग्वेज प्रोसेसिंग, सरल भाषा में समझाया गया
हर बार जब आप किसी वॉइस असिस्टेंट से मौसम पूछते हैं, ऑटो-जेनरेटेड सबटाइटल के साथ कोई वीडियो देखते हैं, या देखते हैं कि आपका ईमेल ऐप आपका वाक्य पूरा कर रहा है, तो आप नेचुरल लैंग्वेज प्रोसेसिंग का इस्तेमाल कर रहे होते हैं। अगर आपने कभी सोचा है कि एनएलपी क्या है और यह अचानक हर जगह क्यों दिखाई देने लगा है, तो यह गाइड आपके लिए है। हम इस अवधारणा को सरल भाषा में समझाएँगे, देखेंगे कि यह असल में काम कैसे करता है, और उन रोज़मर्रा के अनुप्रयोगों की सैर करेंगे जिन पर आप शायद पहले से ही निर्भर हैं — इसके लिए कंप्यूटर साइंस की डिग्री की कोई ज़रूरत नहीं है।
सरल शब्दों में एनएलपी क्या है?
नेचुरल लैंग्वेज प्रोसेसिंग, जिसे आमतौर पर एनएलपी कहा जाता है, आर्टिफ़िशियल इंटेलिजेंस की वह शाखा है जो कंप्यूटरों को मानव भाषा समझने, उसकी व्याख्या करने और उसे उत्पन्न करने में मदद करती है। “नेचुरल लैंग्वेज” का सीधा मतलब है वह तरीका जिससे लोग स्वाभाविक रूप से बात करते और लिखते हैं — स्लैंग, अस्पष्टता, टाइपो और संदर्भ से भरा हुआ — जो किसी प्रोग्रामिंग भाषा के सटीक आदेशों से बिल्कुल अलग है।
चुनौती असली है। जब कोई दोस्त मैसेज करता है “that’s sick,” तो उसका मतलब हो सकता है कि कुछ बेहतरीन है, घिनौना है, या सचमुच बीमार है। इंसान संदर्भ का इस्तेमाल करके इस अस्पष्टता को तुरंत सुलझा लेते हैं। एनएलपी उन तकनीकों का समूह है जो मशीनों को भी ऐसी ही क्षमता देने की कोशिश करती है, ताकि सॉफ़्टवेयर किसी प्रोडक्ट रिव्यू को पढ़कर निराशा भाँप सके, कोई बोला गया सवाल सुनकर उसका जवाब दे सके, या किसी पैराग्राफ़ का स्पेनिश से अंग्रेज़ी में अनुवाद कर सके।
एनएलपी, एआई और मशीन लर्निंग: ये एक-दूसरे से कैसे जुड़े हैं
ये शब्द एक-दूसरे के अंदर समाए हुए हैं। आर्टिफ़िशियल इंटेलिजेंस वह व्यापक लक्ष्य है जिसमें मशीनें वे कार्य करती हैं जिनके लिए आमतौर पर मानव बुद्धि की ज़रूरत होती है। मशीन लर्निंग वहाँ तक पहुँचने का प्रमुख तरीका है, जिसमें सिस्टम हस्तलिखित नियमों का पालन करने के बजाय डेटा से पैटर्न सीखते हैं। एनएलपी उन्हीं तरीकों का भाषा पर अनुप्रयोग है। जब आप आधुनिक चैटबॉट के पीछे काम करने वाले लार्ज लैंग्वेज मॉडल के बारे में सुनते हैं, तो आप विशाल पैमाने पर प्रशिक्षित एनएलपी सिस्टम के बारे में सुन रहे होते हैं।
एनएलपी का एक बहुत संक्षिप्त इतिहास
एनएलपी उतना पुराना है जितना ज़्यादातर लोग सोचते भी नहीं। 1950 के दशक में, शोधकर्ताओं ने नियम-आधारित सिस्टम बनाए जो शब्दकोशों और व्याकरण के नियमों का इस्तेमाल करके भाषाओं के बीच अनुवाद करते थे। ये सिस्टम संकरे, अनुमानित वाक्यों के लिए काम करते थे और असली दुनिया में जल्दी ही टूट जाते थे।
यह क्षेत्र चरणों में बदला। 1990 के दशक में सांख्यिकीय तरीकों ने कंप्यूटरों को नियमों के बजाय उदाहरणों से सीखने दिया। 2010 के दशक में डीप लर्निंग ने न्यूरल नेटवर्क लाए जो टेक्स्ट में कहीं अधिक समृद्ध पैटर्न पकड़ सकते थे। फिर, 2017 में, शोधकर्ताओं ने ट्रांसफ़ॉर्मर आर्किटेक्चर पेश किया, जिसने मॉडलों को किसी वाक्य के हर शब्द के महत्व को हर दूसरे शब्द के सापेक्ष तौलने दिया। यही सफलता आज के चैटबॉट, अनुवादकों और राइटिंग असिस्टेंट को शक्ति देती है, और यही वजह है कि एनएलपी की गुणवत्ता कुछ ही वर्षों में इतनी उल्लेखनीय रूप से बढ़ गई।
एनएलपी असल में काम कैसे करता है?
आधुनिक एनएलपी पाइपलाइन कार्य के अनुसार अलग-अलग होती हैं, लेकिन ज़्यादातर में कुछ मुख्य चरण साझा होते हैं।
चरण 1: टेक्स्ट को टोकन में तोड़ना
सबसे पहले, सिस्टम टेक्स्ट को छोटी इकाइयों में बाँटता है जिन्हें टोकन कहा जाता है — मोटे तौर पर, शब्द और शब्दों के टुकड़े। “Unbelievable” “un,” “believ,” और “able” बन सकता है। टोकनाइज़ करने से मॉडल उन शब्दों को संभाल सकता है जिन्हें उसने पूरा कभी नहीं देखा, उनके हिस्सों को पहचानकर।
चरण 2: शब्दों को संख्याओं में बदलना
कंप्यूटर कच्चे शब्दों पर तर्क नहीं कर सकते, इसलिए हर टोकन को संख्याओं की एक सूची में बदल दिया जाता है जिसे एम्बेडिंग कहते हैं। एम्बेडिंग अर्थ को ज्यामितीय रूप से पकड़ती हैं: समान संदर्भों में इस्तेमाल होने वाले शब्द, जैसे “king” और “queen” या “happy” और “joyful,” के अंक समान हो जाते हैं। इसी तरह कोई मॉडल समझ सकता है कि “inexpensive” और “cheap” अर्थ में करीब हैं, भले ही उनमें कोई अक्षर साझा न हो।
चरण 3: संदर्भ पर ध्यान देना
ट्रांसफ़ॉर्मर मॉडल अटेंशन नामक एक तंत्र का इस्तेमाल करके तय करते हैं कि हर शब्द को समझने के लिए कौन से शब्द सबसे ज़्यादा मायने रखते हैं। “The bank by the river bank was steep,” में अटेंशन मॉडल को यह समझने में मदद करता है कि कौन सा “bank” वित्तीय संस्थान का अर्थ देता है (इस मामले में, कोई भी नहीं) और कौन सा नदी के किनारे का। इस तरह संसाधित संदर्भ ही वह चीज़ है जो आधुनिक एनएलपी को अतीत के भंगुर नियम-आधारित सिस्टम से अलग करता है।
चरण 4: भारी मात्रा में टेक्स्ट पर प्रशिक्षण
इस सबके उपयोगी होने से पहले, मॉडल किताबों, लेखों और वेब पेजों के विशाल संग्रहों को पढ़कर प्रशिक्षित होता है, लगातार गुम या अगले शब्दों की भविष्यवाणी करता हुआ। अरबों छोटे-छोटे सुधार उसे व्याकरण, तथ्य, शैली और तर्क के पैटर्न सिखाते हैं। फिर फ़ाइन-ट्यूनिंग उस सामान्य ज्ञान को ग्राहक सवालों के जवाब देने या कानूनी दस्तावेज़ों का सारांश बनाने जैसे विशिष्ट कार्यों के अनुकूल बनाती है।
एनएलपी के रोज़मर्रा के उदाहरण जो आप पहले से इस्तेमाल करते हैं
एनएलपी उन टूल्स के अंदर छिपा होता है जो इतने परिचित हैं कि हम भूल जाते हैं कि यह वहाँ है:
- स्पैम फ़िल्टर आने वाले ईमेल को पढ़ते हैं और तय करते हैं कि यह कबाड़ जैसा दिखता है या नहीं।
- सर्च इंजन यह व्याख्या करते हैं कि आपका मतलब क्या है, सिर्फ़ यह नहीं कि आपने क्या टाइप किया, और आपकी टाइपो को माफ़ कर देते हैं।
- वॉइस असिस्टेंट बोली को टेक्स्ट में बदलते हैं, अनुरोध को समझते हैं, और उस पर कार्रवाई करते हैं।
- अनुवाद ऐप भाषाओं के बीच रीयल टाइम में अनुवाद करते हैं, फ़ोटो खींचे गए साइनबोर्ड समेत।
- ऑटोकंप्लीट और व्याकरण जाँचकर्ता आपके अगले शब्द की भविष्यवाणी करते हैं और अटपटे वाक्यांशों को चिह्नित करते हैं।
- भावना विश्लेषण (सेंटिमेंट एनालिसिस) कंपनियों को हज़ारों रिव्यू स्कैन करके बढ़ते गुस्से या खुशी का पता लगाने देता है।
- चैटबॉट और एआई असिस्टेंट बातचीत करते हैं, सवालों के जवाब देते हैं, और अनुरोध पर टेक्स्ट का मसौदा तैयार करते हैं।
एनएलपी के मुख्य कार्य, समझाए गए
भावना विश्लेषण (सेंटिमेंट एनालिसिस)
भावना विश्लेषण टेक्स्ट को सकारात्मक, नकारात्मक या तटस्थ के रूप में वर्गीकृत करता है — और तेज़ी से निराशा या तात्कालिकता जैसी सूक्ष्म भावनाओं का भी पता लगाता है। व्यवसाय इसका इस्तेमाल हर टिप्पणी को मैन्युअल रूप से पढ़े बिना रिव्यू और सोशल मीडिया पर ब्रांड की स्थिति की निगरानी के लिए करते हैं।
मशीन अनुवाद
आधुनिक अनुवाद सिस्टम शब्द-दर-शब्द के बजाय पूरे वाक्य एक साथ पढ़ते हैं, यही वजह है कि आज के अनुवाद एक दशक पहले के अटपटे परिणामों की तुलना में मुहावरों और लहजे को कहीं बेहतर बनाए रखते हैं।
सारांश और प्रश्न-उत्तर
एनएलपी चालीस पेज की रिपोर्ट को पाँच बुलेट पॉइंट में समेट सकता है या दस्तावेज़ों के ढेर से किसी विशिष्ट सवाल का जवाब दे सकता है। ये क्षमताएँ शोध टूल, ग्राहक सहायता खोज, और अब ऑफ़िस सॉफ़्टवेयर में दिखाई देने वाले दस्तावेज़ सहायकों की नींव हैं।
टेक्स्ट जेनरेशन
सबसे ज़्यादा दिखाई देने वाली हालिया प्रगति है जेनरेशन: ईमेल, लेख, कोड टिप्पणियों और प्रोडक्ट विवरणों का मसौदा तैयार करना। जेनरेशन वह जगह भी है जहाँ व्यवसायों को सीधे उत्पादकता लाभ मिल रहे हैं। छोटे व्यवसायों के लिए एआई ऑटोमेशन पर हमारी गाइड में, हम दिखाते हैं कि मालिक भाषा टूल का इस्तेमाल जवाबों का मसौदा तैयार करने, पूछताछ का सारांश बनाने और संदेशों को सही जगह भेजने के लिए कैसे करते हैं — व्यावहारिक एनएलपी जो हर दिन अग्लैमरस लेकिन मूल्यवान काम करता है।
एनएलपी आगे कहाँ जा रहा है
एनएलपी सिस्टम की नवीनतम पीढ़ी भाषा को अलग-थलग संसाधित करने से कहीं ज़्यादा करती है। यह क्षेत्र किस दिशा में बढ़ रहा है, यह समझना आपको हर महीने आने वाले प्रोडक्ट को समझने में मदद करता है।
मल्टीमॉडल समझ
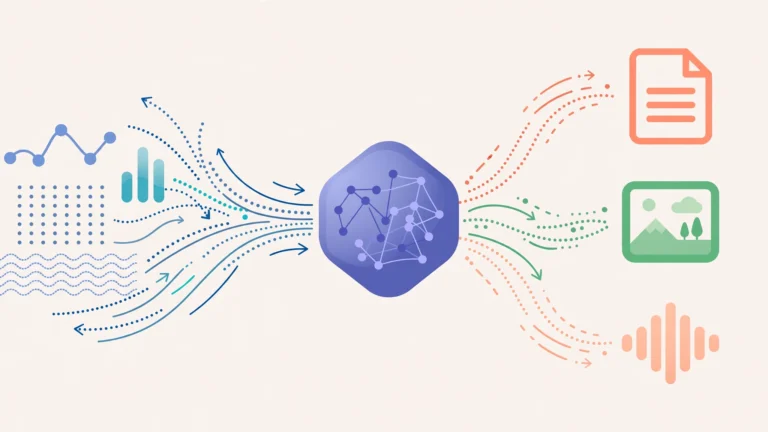
आधुनिक मॉडल तेज़ी से भाषा को छवियों, ऑडियो और वीडियो के साथ संभालते हैं। आप किसी मॉडल को किसी टूटे उपकरण की फ़ोटो दिखाकर सरल शब्दों में पूछ सकते हैं कि कौन सा पार्ट ऑर्डर करना है — यह छवि और आपके सवाल को एक संयुक्त इनपुट के रूप में पढ़ता है। ग्राहक सहायता, शिक्षा और सुलभता (एक्सेसिबिलिटी) टूल इस क्षमता के इर्द-गिर्द फिर से बनाए जा रहे हैं: कोई छात्र गणित की समस्या की फ़ोटो खींचता है और बोली हुई व्याख्या पाता है; कोई तकनीशियन किसी मशीन पर फ़ोन घुमाता है और संबंधित मैनुअल खंड ज़ोर से पढ़ा हुआ सुनता है।
रीयल-टाइम बातचीत
वॉइस इंटरैक्शन का मतलब पहले आदेश चिल्लाना और इंतज़ार करना होता था। विलंबता (लेटेंसी) इतनी घट गई है कि एआई के साथ बोली हुई बातचीत किसी इंसान से बात करने जैसी लगती है, बीच में टोकना और फ़ॉलो-अप सवाल समेत। कॉल सेंटर, भाषा ट्यूशन, और कारों व रसोई में हैंड्स-फ़्री सहायता शुरुआती लाभार्थी हैं, और टाइप की गई व बोली गई एनएलपी के बीच गुणवत्ता का अंतर तेज़ी से बंद हो रहा है।
छोटे, निजी, ऑन-डिवाइस मॉडल
हर प्रगति का मतलब बड़ा होना नहीं है। सीधे फ़ोन और लैपटॉप पर चलने वाले कॉम्पैक्ट मॉडल अब आपके शब्दों को किसी सर्वर पर भेजे बिना डिक्टेशन, सारांश और स्मार्ट जवाब संभालते हैं। यह गोपनीयता के लिए, गति के लिए, और अरबों लोगों के लिए मायने रखता है जिनके पास अविश्वसनीय इंटरनेट कनेक्शन हैं।
काम पर एनएलपी: आपके करियर के लिए इसका क्या मतलब है
चाहे आपकी नौकरी के शीर्षक में टेक्नोलॉजी का ज़िक्र हो या न हो, एनएलपी चुपचाप स्प्रेडशीट या ईमेल जैसी एक कार्यस्थल कुशलता बनता जा रहा है।
रोज़मर्रा के पेशेवर उपयोग
मार्केटर मिनटों में कैंपेन कॉपी का मसौदा तैयार करते हैं और उसका परीक्षण करते हैं। वकील केस फ़ाइलों को खोजते और सारांशित करते हैं जिनकी समीक्षा में पहले हफ़्ते लगते थे। डॉक्टर नोट्स बोलकर लिखवाते हैं जिन्हें एनएलपी मेडिकल रिकॉर्ड में ढालता है। भर्तीकर्ता आवेदन सारांशों की जाँच करते हैं — आदर्श रूप से मानवीय निगरानी के साथ, क्योंकि भाषा मॉडल ऐतिहासिक डेटा से पूर्वाग्रह विरासत में ले सकते हैं। सहायता टीमें नियमित सवाल चैटबॉट से सुलझवाती हैं जबकि लोग नाज़ुक सवाल संभालते हैं। हर मामले में, पैटर्न एक ही है: मशीन मात्रा को संसाधित करती है और मसौदा बनाती है, इंसान निर्णय लेता है और फ़ैसला करता है।
कौशल जो मूल्यवान बने रहते हैं
जैसे-जैसे भाषा टूल फैलते हैं, प्रीमियम उन क्षमताओं की ओर खिसकता है जो मशीनों में नहीं हैं: सही सवाल पूछना, आत्मविश्वास से भरे लगने वाले जवाब की पुष्टि करना, दर्शकों को समझना, और अंतिम शब्द की ज़िम्मेदारी लेना। स्पष्ट लेखन कम नहीं, ज़्यादा मूल्यवान बनता है, क्योंकि जो व्यक्ति किसी एआई को सटीक निर्देश दे सकता है — और पहचान सकता है कि उसका आउटपुट कब सूक्ष्म रूप से ग़लत है — वह उससे नाटकीय रूप से ज़्यादा पाता है जो ऐसा नहीं कर सकता। एनएलपी के साथ काम करना सीखना टूल याद करने के बारे में कम है, जो हर साल बदलते हैं, और उस संपादकीय विवेक को विकसित करने के बारे में ज़्यादा है।
कठिन समस्याएँ जिनका एनएलपी अभी भी सामना करता है
अपनी सारी प्रगति के बावजूद, एनएलपी हल नहीं हुआ है। व्यंग्य और हास्य अभी भी मॉडलों को चकमा देते हैं। कम प्रशिक्षण डेटा वाली भाषाएँ — और ऐसी हज़ारों हैं — अंग्रेज़ी की तुलना में उल्लेखनीय रूप से ख़राब टूल पाती हैं। मॉडल आत्मविश्वास से झूठे बयान उत्पन्न कर सकते हैं, एक विफलता का तरीका जिसे हैलुसिनेशन कहा जाता है, यही वजह है कि चिकित्सा, कानूनी और वित्तीय टेक्स्ट के लिए मानवीय समीक्षा अनिवार्य बनी हुई है। और क्योंकि मॉडल मानव लेखन से सीखते हैं, वे उस डेटा में मौजूद मानवीय पूर्वाग्रहों को विरासत में ले सकते हैं। इन सीमाओं को समझना एनएलपी का ज़िम्मेदारी से उपयोग करने का हिस्सा है: आउटपुट को एक तेज़, जानकार, कभी-कभी अति-आत्मविश्वासी सहायक के मसौदों के रूप में लें।
आप जिन एनएलपी टूल का उपयोग करते हैं, उनसे ज़्यादा कैसे पाएँ
एनएलपी से लाभ उठाने के लिए आपको तकनीकी कौशल की ज़रूरत नहीं है — लेकिन कुछ आदतें नाटकीय रूप से सुधारती हैं कि आपको इससे क्या मिलता है।
आप क्या चाहते हैं, इसके बारे में विशिष्ट रहें
भाषा मॉडल भाषा पर प्रतिक्रिया देते हैं, इसलिए अस्पष्ट अनुरोध अस्पष्ट जवाब कमाते हैं। “मार्केटिंग के बारे में कुछ लिखो” के बजाय, कोशिश करें “हमारे वफ़ादार ग्राहकों को हमारी स्प्रिंग सेल की घोषणा करने वाला एक दोस्ताना 100-शब्दों का ईमेल तैयार करो, जिसमें एक स्पष्ट कॉल टू एक्शन हो।” दर्शक, लंबाई, लहजा और उद्देश्य निर्दिष्ट करना मॉडल को वह संदर्भ देता है जिसकी उसे ज़रूरत है, बिल्कुल वैसे ही जैसे यह किसी मानव सहकर्मी की मदद करता है।
दोहराएँ और सत्यापित करें
पहले आउटपुट को एक मसौदे के रूप में लें। छोटा संस्करण, अलग लहजा, या मज़बूत शुरुआत माँगें — बातचीत के ज़रिए निखारना ही वह जगह है जहाँ ये टूल चमकते हैं। फिर जो कुछ भी तथ्यात्मक है उसे सत्यापित करें: नाम, तारीख़ें, आँकड़े और उद्धरण। एनएलपी सिस्टम ग़लत होने पर भी धाराप्रवाह होते हैं, इसलिए महत्वपूर्ण दावों पर तीस सेकंड की जाँच आधुनिक ज्ञान-कार्य में सबसे सस्ता बीमा है।
संवेदनशील जानकारी की रक्षा करें
अंत में, याद रखें कि जो टेक्स्ट आप ऑनलाइन टूल में पेस्ट करते हैं, वह सेवा की नीतियों के आधार पर संग्रहीत या समीक्षित किया जा सकता है। गोपनीय अनुबंध, व्यक्तिगत डेटा, या अप्रकाशित व्यावसायिक योजनाएँ उपभोक्ता टूल में डालने से बचें; जब सामग्री संवेदनशील हो तो स्पष्ट डेटा गारंटी वाले एंटरप्राइज़ संस्करणों का उपयोग करें।
अक्सर पूछे जाने वाले प्रश्न
क्या एनएलपी एक लार्ज लैंग्वेज मॉडल के समान है?
बिल्कुल नहीं। एनएलपी वह क्षेत्र है — कंप्यूटरों को भाषा के साथ काम कराने का पूरा अनुशासन। लार्ज लैंग्वेज मॉडल उस क्षेत्र के भीतर एक शक्तिशाली टूल है। कीवर्ड निष्कर्षण और नियम-आधारित पार्सिंग जैसी पुरानी एनएलपी तकनीकें आधुनिक मॉडलों के साथ-साथ बहुत सारे सॉफ़्टवेयर के अंदर अभी भी चलती हैं।
क्या एनएलपी का उपयोग करने के लिए मुझे कोडिंग आनी चाहिए?
नहीं। ज़्यादातर लोग एनएलपी का उपयोग तैयार प्रोडक्ट के ज़रिए करते हैं: चैटबॉट, अनुवाद ऐप, राइटिंग असिस्टेंट और वॉइस असिस्टेंट। प्रोग्रामिंग केवल तभी ज़रूरी है जब आप अपने ख़ुद के भाषा-संचालित एप्लिकेशन बनाना चाहते हैं या बड़े पैमाने पर टेक्स्ट का विश्लेषण करना चाहते हैं।
क्या एनएलपी मानव लेखकों और अनुवादकों की जगह ले लेगा?
यह उन नौकरियों को ख़त्म करने से ज़्यादा उन्हें बदल रहा है। एनएलपी पहले मसौदे, नियमित अनुवाद और उच्च-मात्रा सारांश अच्छी तरह संभालता है, लेकिन निर्णय, सांस्कृतिक बारीकी, जवाबदेही और मौलिक रिपोर्टिंग में इंसान अभी भी आगे हैं। आज फलने-फूलने वाले पेशेवर आमतौर पर एनएलपी को एक त्वरक के रूप में उपयोग करते हैं, न कि उससे प्रतिस्पर्धा करते हैं।
निष्कर्ष
तो, एनएलपी क्या है? यह वह तकनीक है जो कंप्यूटरों को मानव भाषा पढ़ने, सुनने, समझने और उत्पन्न करने देती है — टोकन, एम्बेडिंग, अटेंशन और भारी मात्रा में टेक्स्ट पर प्रशिक्षण से बनी हुई। आप इसे पहले से ही अपने इनबॉक्स, अपने सर्च बार और अपने फ़ोन के वॉइस असिस्टेंट में इस्तेमाल करते हैं। जैसे-जैसे मॉडल बेहतर होते जाएँगे, बातचीत सॉफ़्टवेयर चलाने जैसी कम और बातचीत करने जैसी ज़्यादा लगेगी। यह कैसे काम करता है — और यह अभी कहाँ कम पड़ता है — इसकी बुनियादी बातें जानना आपको काम पर और हर जगह इससे लाभ उठाने की सबसे अच्छी स्थिति में रखता है।