मशीन लर्निंग बनाम डीप लर्निंग, सरल भाषा में समझाया गया
अगर आपने आर्टिफ़िशियल इंटेलिजेंस के बारे में पढ़ने में कुछ समय बिताया है, तो आपने शायद इन शब्दों को लगभग एक-दूसरे के स्थान पर इस्तेमाल होते देखा होगा। मशीन लर्निंग बनाम डीप लर्निंग को समझना इस उलझन को दूर करने का सबसे तेज़ तरीका है। संक्षेप में बात सरल है: डीप लर्निंग, मशीन लर्निंग का एक विशेष प्रकार है, और मशीन लर्निंग, आर्टिफ़िशियल इंटेलिजेंस के व्यापक क्षेत्र का एक हिस्सा है। लेकिन ये कैसे सीखते हैं, इन्हें कितने डेटा की ज़रूरत होती है, और ये किन कामों में अच्छे हैं — इनमें अंतर बहुत मायने रखता है, ख़ासकर तब जब आप टूल चुन रहे हों, लोगों को नौकरी पर रख रहे हों, या बस उस तकनीक को समझने की कोशिश कर रहे हों जो आपकी दुनिया को आकार दे रही है।
यह गाइड दोनों तरीकों को सरल भाषा में समझाती है — रोज़मर्रा के उदाहरणों, ईमानदार समझौतों (ट्रेड-ऑफ़) और एक व्यावहारिक ढाँचे के साथ, ताकि आप तय कर सकें कि किसी समस्या के लिए कौन-सा तरीका उपयुक्त है।
सबसे पहले, बड़ी तस्वीर: AI, मशीन लर्निंग, डीप लर्निंग
तीन एक-दूसरे के अंदर रखे डिब्बों की कल्पना कीजिए। सबसे बड़ा डिब्बा है आर्टिफ़िशियल इंटेलिजेंस: कोई भी तकनीक जो कंप्यूटर को ऐसा काम करने देती है जिसके लिए सामान्यतः मानवीय बुद्धि की ज़रूरत लगती है — शतरंज खेलने से लेकर भाषण को समझने तक। उस डिब्बे के अंदर है मशीन लर्निंग: ऐसे सिस्टम जो केवल हाथ से लिखे नियमों का पालन करने के बजाय, डेटा से पैटर्न सीखकर किसी काम में बेहतर होते जाते हैं। और मशीन लर्निंग के अंदर है डीप लर्निंग: बड़े, कई परतों वाले न्यूरल नेटवर्क पर आधारित तरीकों का एक परिवार, जो कच्चे डेटा से अपने आप फ़ीचर सीख लेते हैं।
सारा AI मशीन लर्निंग नहीं होता। एक पुराने ज़माने का शतरंज प्रोग्राम जो प्रोग्रामरों द्वारा लिखे नियमों का पालन करता है, वह AI है, लेकिन वह डेटा से नहीं सीखता। और सारी मशीन लर्निंग डीप लर्निंग नहीं होती। एक मॉडल जो फ़ीचरों की स्प्रेडशीट से घर की कीमतों का अनुमान लगाता है, वह मशीन लर्निंग है, लेकिन उसमें कोई डीप नेटवर्क शामिल नहीं होता। इन परतों को स्पष्ट रखना बहुत-सी उलझी हुई सोच — और उलझे हुए ख़रीद फ़ैसलों — को रोकता है।
मशीन लर्निंग क्या है?
मशीन लर्निंग (ML) एक गणितीय मॉडल को उदाहरणों पर प्रशिक्षित (ट्रेन) करने की प्रक्रिया है, ताकि वह नए डेटा पर भविष्यवाणियाँ या फ़ैसले कर सके। कंप्यूटर को हर स्थिति में ठीक-ठीक क्या करना है, यह बताने के बजाय, आप उसे इनपुट और सही आउटपुट के कई उदाहरण दिखाते हैं, और एक एल्गोरिदम ख़ुद को तब तक समायोजित करता है जब तक उसकी भविष्यवाणियाँ उदाहरणों से क़रीब से मेल नहीं खाने लगतीं।
मशीन लर्निंग कैसे सीखती है
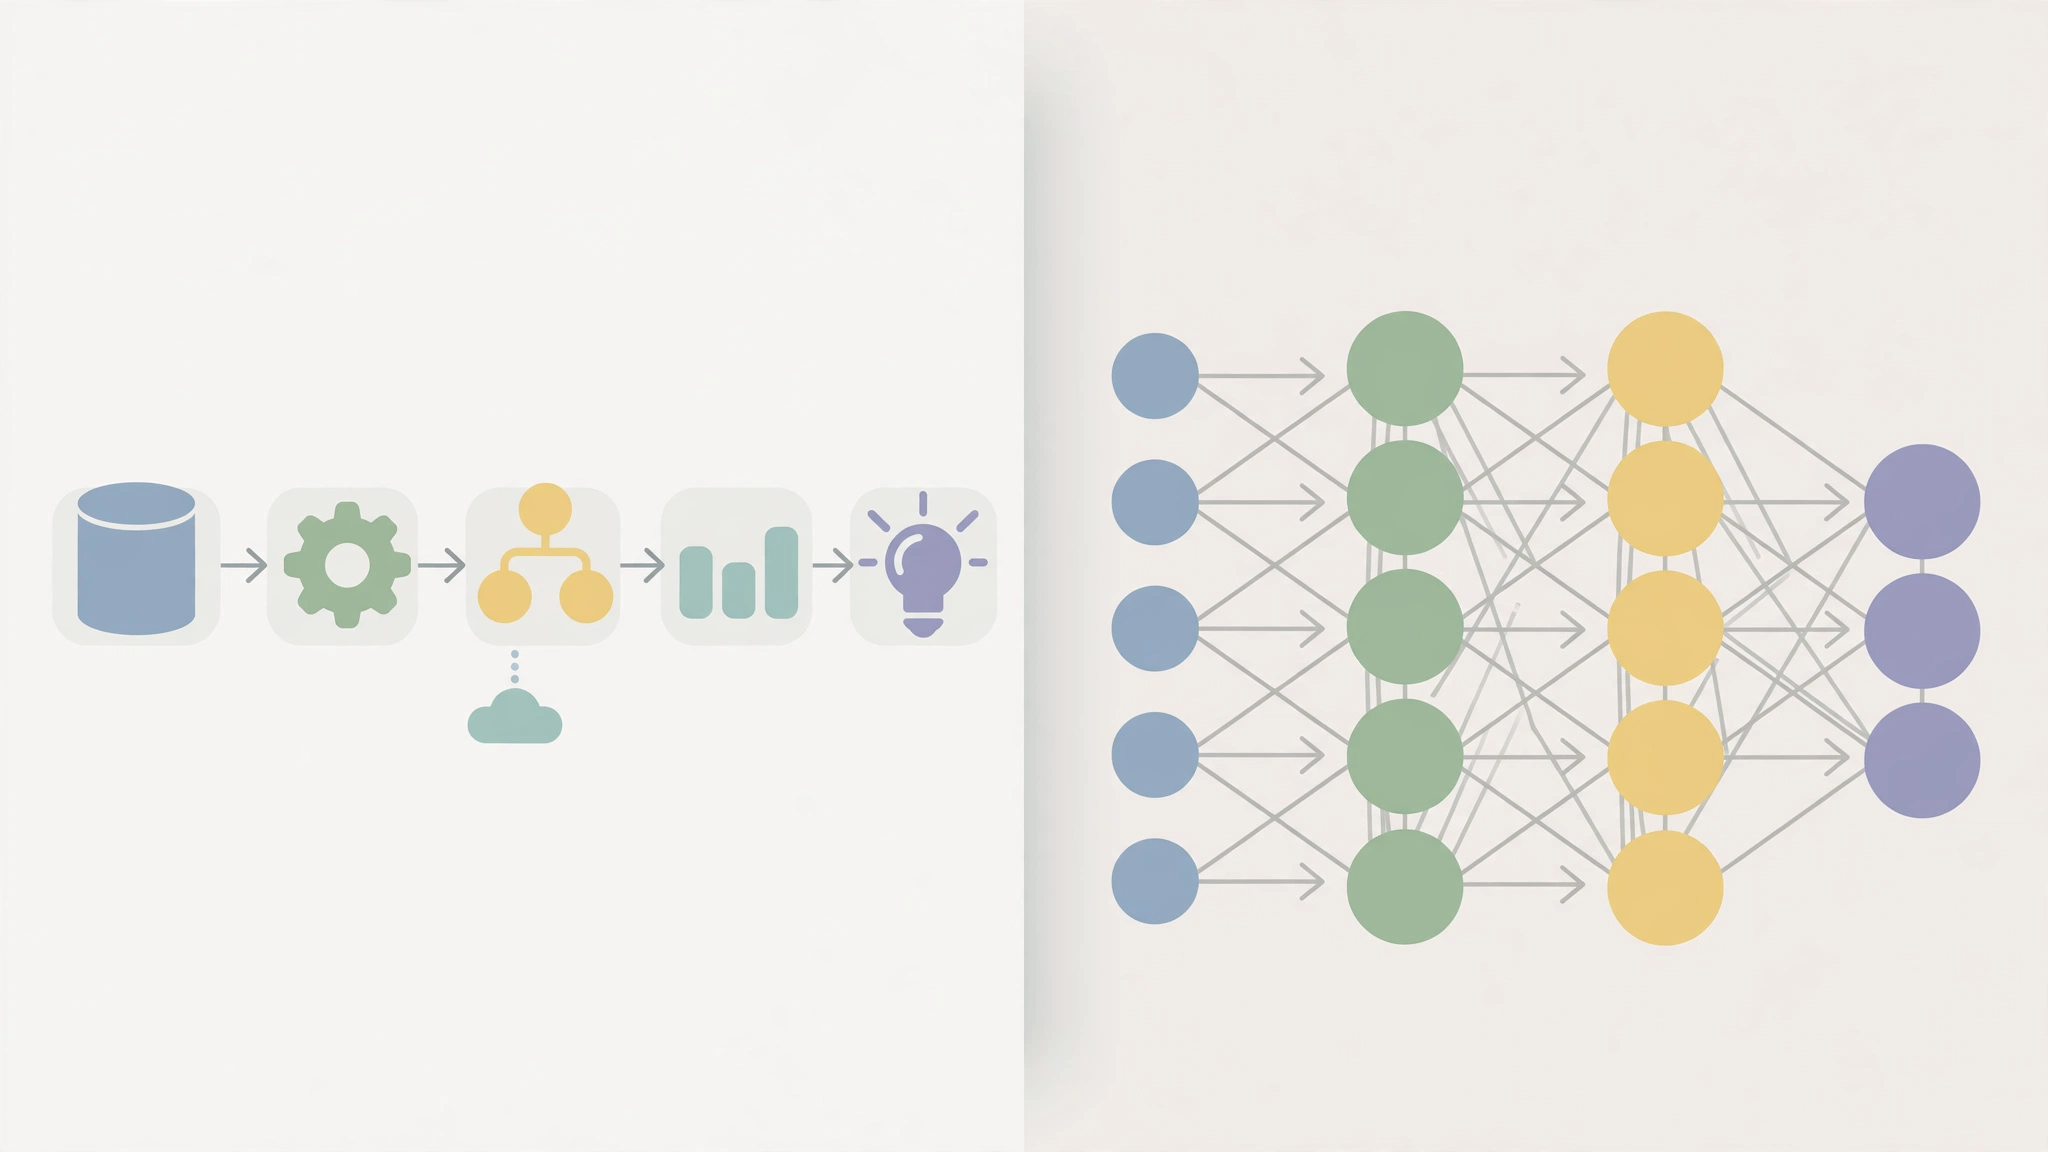
एक आम ML वर्कफ़्लो कुछ इस तरह दिखता है: आप डेटा इकट्ठा करते हैं, उसे साफ़ करते हैं, और तय करते हैं कि कौन-से माप — जिन्हें फ़ीचर कहा जाता है — हर उदाहरण का वर्णन करते हैं। एक स्पैम फ़िल्टर के लिए, फ़ीचर में यह शामिल हो सकता है कि किसी ईमेल में कितने विस्मयादिबोधक चिह्न हैं, उसमें कुछ संदिग्ध वाक्यांश हैं या नहीं, और भेजने वाला आपकी संपर्क सूची में है या नहीं। एक मानव विशेषज्ञ उन फ़ीचरों को चुनता है और तैयार करता है। फिर डिसीजन ट्री, रैंडम फ़ॉरेस्ट या लॉजिस्टिक रिग्रेशन जैसा कोई एल्गोरिदम सीखता है कि उन्हें कितना महत्व देना है।
महत्वपूर्ण बात यह है कि इंसान शुरू में ही बहुत-सा बौद्धिक भारी काम कर देता है: डेटा चुनना, फ़ीचर तय करना और एल्गोरिदम चुनना। मशीन उस ढाँचे के भीतर बारीक पैटर्न सीखती है।
आम मशीन लर्निंग एल्गोरिदम
- लीनियर और लॉजिस्टिक रिग्रेशन — रुझानों और हाँ/नहीं भविष्यवाणियों के लिए सरल, तेज़ मॉडल।
- डिसीजन ट्री और रैंडम फ़ॉरेस्ट — फ़्लोचार्ट जैसे मॉडल जिन्हें समझना आसान होता है।
- सपोर्ट वेक्टर मशीन — श्रेणियों के बीच सीमाएँ खींचने में अच्छे।
- ग्रेडिएंट बूस्टिंग — ऐसे एन्सेम्बल जो अक्सर टेबुलर-डेटा प्रतियोगिताएँ जीतते हैं।
- K-मीन्स क्लस्टरिंग — बिना लेबल के समान चीज़ों को एक साथ समूहबद्ध करता है।
डीप लर्निंग क्या है?
डीप लर्निंग (DL) कई परतों वाले न्यूरल नेटवर्क का इस्तेमाल करती है — इसीलिए “डीप” — ताकि वह सीधे कच्चे डेटा से सीख सके। इंसान के हाथ से फ़ीचर तैयार करने के बजाय, नेटवर्क उपयोगी फ़ीचर ख़ुद खोज लेता है। एक डीप नेटवर्क को लाखों लेबल की हुई तस्वीरें दीजिए, और उसकी शुरुआती परतें किनारे और बनावट पहचानना सीखती हैं, बीच की परतें आँखों और पहियों जैसी आकृतियाँ सीखती हैं, और बाद की परतें पूरी वस्तुएँ सीखती हैं। किसी ने इसमें “आई डिटेक्टर” प्रोग्राम नहीं किया था; वह संरचना प्रशिक्षण से उभरी।
डीप लर्निंग कैसे सीखती है
एक न्यूरल नेटवर्क परतों में व्यवस्थित जुड़ी हुई इकाइयों से बना होता है। हर कनेक्शन का एक वज़न (वेट) होता है। प्रशिक्षण के दौरान, नेटवर्क एक भविष्यवाणी करता है, मापता है कि वह कितनी ग़लत थी, और लाखों वज़नों को सही दिशा में थोड़ा-थोड़ा खिसकाता है — इस प्रक्रिया को बैकप्रॉपैगेशन कहा जाता है। इसे लाखों बार दोहराइए, और नेटवर्क चेहरे पहचानने, भाषण को लिखित रूप में बदलने और भाषाओं का अनुवाद करने जैसे कामों में उल्लेखनीय रूप से अच्छा हो जाता है।
लेकिन एक पेंच है: इस ताक़त के लिए भारी मात्रा में लेबल किया हुआ डेटा और गंभीर कंप्यूटिंग शक्ति चाहिए, आमतौर पर GPU नामक विशेष चिप्स। डीप लर्निंग को समझना भी कठिन होता है — जब कोई डीप नेटवर्क ग़लती करता है, तो यह समझाना सचमुच मुश्किल हो सकता है कि क्यों।
मुख्य अंतर एक नज़र में
डेटा की ज़रूरतें
पारंपरिक मशीन लर्निंग सैकड़ों या हज़ारों उदाहरणों के साथ भी अच्छा प्रदर्शन कर सकती है। डीप लर्निंग को आम तौर पर दसियों हज़ार से लेकर लाखों उदाहरण चाहिए। अगर आपका डेटासेट एक छोटी-सी स्प्रेडशीट है, तो ML आमतौर पर सही टूल है। अगर आपके पास तस्वीरों, ऑडियो या टेक्स्ट का पहाड़ है, तो DL व्यवहार्य हो जाती है।
फ़ीचर इंजीनियरिंग
क्लासिक ML में, इंसान फ़ीचर डिज़ाइन करते हैं, और मॉडल की गुणवत्ता उस कौशल पर बहुत निर्भर करती है। डीप लर्निंग में, नेटवर्क कच्चे इनपुट से अपने फ़ीचर ख़ुद सीखता है। यही वजह है कि DL ने कंप्यूटर विज़न और स्पीच जैसे क्षेत्रों में क्रांति ला दी, जहाँ हाथ से फ़ीचर डिज़ाइन करना हमेशा एक अड़चन था।
हार्डवेयर और प्रशिक्षण का समय
कई ML मॉडल एक साधारण लैपटॉप पर सेकंडों या मिनटों में प्रशिक्षित हो जाते हैं। डीप लर्निंग मॉडलों को महँगे GPU हार्डवेयर पर घंटे, दिन या उससे भी ज़्यादा समय लग सकता है। इन्फ़रेंस — यानी प्रशिक्षित मॉडल का असल इस्तेमाल — भी डीप नेटवर्क के लिए भारी हो सकता है।
व्याख्या-योग्यता (इंटरप्रेटेबिलिटी)
एक डिसीजन ट्री को छापकर पढ़ा जा सकता है। दस करोड़ वज़नों वाले डीप नेटवर्क को नहीं। ऋण या चिकित्सा जैसे विनियमित क्षेत्रों में, किसी फ़ैसले को समझाने की क्षमता कोई विलासिता नहीं है; यह अक्सर एक कानूनी ज़रूरत होती है, और यह टीमों को सरल ML की ओर धकेलती है।
प्रदर्शन की सीमा
बड़े, अव्यवस्थित, असंरचित डेटा — तस्वीरें, वीडियो, ऑडियो, मुक्त टेक्स्ट — पर डीप लर्निंग आमतौर पर बड़े अंतर से जीतती है। साफ़, संरचित, टेबुलर डेटा पर, अच्छी तरह ट्यून की गई क्लासिक ML अक्सर लागत के एक छोटे हिस्से में डीप लर्निंग के बराबर या उससे बेहतर प्रदर्शन करती है।
दोनों के वास्तविक उदाहरण
काम करती क्लासिक मशीन लर्निंग: एक बैंक जो आय, इतिहास और कर्ज़ के फ़ीचरों से ऋण आवेदनों को स्कोर करता है; एक रिटेलर जो पिछले रिकॉर्ड से अगले महीने की बिक्री का पूर्वानुमान लगाता है; एक ईमेल प्रदाता जो स्पैम छाँटता है; एक फ़ैक्टरी जो सेंसर रीडिंग से मशीन की खराबी का अनुमान लगाती है।
काम करती डीप लर्निंग: आपका फ़ोन आपके चेहरे से अनलॉक होना; वॉइस असिस्टेंट आपकी बात को लिखित रूप में बदलना; फ़ोटो ऐप आपके कुत्ते की हर तस्वीर ढूँढना; अनुवाद टूल एक पैराग्राफ़ को भाषाओं के बीच बदलना; बड़े लैंग्वेज मॉडल टेक्स्ट तैयार करना और सवालों के जवाब देना।
पैटर्न पर ध्यान दीजिए: जब इनपुट एक साफ़-सुथरी तालिका हो, तो ML सोचिए। जब इनपुट कच्ची धारणा हो — दृश्य, ध्वनियाँ, भाषा — तो DL सोचिए। कई असली उत्पाद दोनों को मिलाते हैं। एक रिकमेंडेशन सिस्टम वीडियो सामग्री को समझने के लिए डीप लर्निंग का और आगे क्या दिखाना है, उसे क्रम देने के लिए क्लासिक ML का इस्तेमाल कर सकता है। छोटे व्यवसायों के लिए AI ऑटोमेशन तलाशने वाले व्यवसायों को भी यही मिश्रण मिलता है: सरल ML चुपचाप पूर्वानुमान और छँटाई संभालती है, जबकि डीप लर्निंग उन चैट और विज़न फ़ीचरों को शक्ति देती है जिन पर ग्राहक असल में ध्यान देते हैं।
आपको असल में किसकी ज़रूरत है?
समस्या से शुरुआत कीजिए, तकनीक से नहीं। चार सवाल पूछिए। पहला, मेरा डेटा कैसा दिखता है — एक तालिका, या कच्चा मीडिया और टेक्स्ट? दूसरा, मेरे पास वह कितना है? तीसरा, क्या मुझे हर फ़ैसले को किसी ग्राहक, ऑडिटर या नियामक को समझाना होगा? चौथा, मैं प्रशिक्षण और संचालन पर कितना ख़र्च कर सकता हूँ?
अगर आपके जवाब एक छोटे, संरचित डेटासेट की ओर इशारा करते हैं जिसमें व्याख्या की ज़रूरत है, तो क्लासिक मशीन लर्निंग लगभग निश्चित रूप से आपका जवाब है — और वह सस्ती, तेज़ और बनाए रखने में आसान होगी। अगर आप बड़े पैमाने पर तस्वीरों, ऑडियो या भाषा के साथ काम कर रहे हैं और सटीकता, व्याख्या से ज़्यादा मायने रखती है, तो डीप लर्निंग अपनी लागत वसूल करती है। और अगर आप अनिश्चित हैं, तो एक सरल ML बेसलाइन से शुरुआत कीजिए। हो सकता है आप पाएँ कि वह बजट के 10 प्रतिशत में समस्या का 90 प्रतिशत हल कर देती है।
मशीनें सीखने के तीन तरीके
दोनों तरीकों में कुछ बुनियादी सीखने की शैलियाँ साझा हैं जिन्हें जानना उपयोगी है, क्योंकि वे आपके इस्तेमाल किए हर उत्पाद में दिखती हैं। सुपरवाइज़्ड लर्निंग में, मॉडल लेबल किए गए उदाहरणों पर प्रशिक्षित होता है — “बिल्ली” या “बिल्ली नहीं” टैग की गई तस्वीरें, स्पैम या नॉन-स्पैम चिह्नित ईमेल — और नई चीज़ों के लिए लेबल का अनुमान लगाना सीखता है। दोनों ख़ेमों के ज़्यादातर व्यावसायिक अनुप्रयोग सुपरवाइज़्ड ही हैं।
अनसुपरवाइज़्ड लर्निंग में, कोई लेबल नहीं होते। एल्गोरिदम ख़ुद संरचना खोजता है: ग्राहकों को समूहों में बाँटना, या उन लेन-देनों को चिह्नित करना जो बाक़ियों से बिल्कुल अलग दिखते हैं। रीइन्फ़ोर्समेंट लर्निंग में, सिस्टम आज़माइश और ग़लती से सीखता है, अच्छे कदमों के लिए इनाम पाता है — यही तकनीक गेम खेलने वाले AI और कुछ रोबोटिक्स के पीछे है। डीप लर्निंग को तीनों शैलियों के साथ जोड़ा जा सकता है, जो एक वजह है कि व्यवहार में इन क्षेत्रों के बीच की सीमा धुँधली होती रहती है।
एक व्यावहारिक उदाहरण: स्पैम फ़िल्टर बनाने के दो तरीके
कल्पना कीजिए कि आप 2005 में एक स्पैम फ़िल्टर बना रहे हैं और फिर आज बना रहे हैं। क्लासिक मशीन लर्निंग वाला संस्करण: एक इंजीनियर संदिग्ध फ़ीचरों की सूची बनाता है — “free” और “winner” जैसे शब्द, अत्यधिक बड़े अक्षर, अजीब भेजने वाले पते — और एक मॉडल सीखता है कि हर फ़ीचर कितना मायने रखता है। यह अच्छी तरह काम करता है, और जब यह ग़लती करता है, तो इंजीनियर ठीक-ठीक देख सकता है कि किस फ़ीचर ने ग़लती करवाई और उसे ठीक कर सकता है।
डीप लर्निंग वाला संस्करण फ़ीचर सूची को पूरी तरह छोड़ देता है। एक न्यूरल नेटवर्क लाखों कच्चे ईमेल पढ़ता है और अपने आंतरिक संकेत ख़ुद सीखता है — वाक्य-रचना, संरचना और भेजने वाले के व्यवहार के ऐसे संयोजन जो किसी इंसान के गिनने के लिए बहुत सूक्ष्म हैं। यह उन नए घोटालों को पकड़ सकता है जिन्हें फ़ीचर सूची चूक जाती, लेकिन जब यह आपके बॉस के ईमेल को चिह्नित करता है, तो घुमाने के लिए कोई एक नॉब नहीं होता; आप बेहतर उदाहरणों के साथ फिर से प्रशिक्षित करते हैं और उम्मीद करते हैं कि पैटर्न ख़ुद ठीक हो जाएगा। कोई भी तरीका अपने आप में “ज़्यादा स्मार्ट” नहीं है — वे नियंत्रण के बदले अनुकूलनशीलता का सौदा करते हैं, और अच्छे इंजीनियर इस आधार पर चुनते हैं कि उनकी समस्या किस सौदे को इनाम देती है।
डीप लर्निंग उसी समय क्यों उड़ी, जब वह उड़ी
न्यूरल नेटवर्क नए नहीं हैं — मूल विचार दशकों पुराने हैं। डीप लर्निंग 2010 के दशक में इसलिए फटी, क्योंकि तीन चीज़ें आख़िरकार एक साथ आईं: इंटरनेट से मिले विशाल डेटासेट, मूल रूप से वीडियो गेम के लिए बने सस्ते और शक्तिशाली GPU, और परिष्कृत प्रशिक्षण तकनीकें जिन्होंने बहुत गहरे नेटवर्क को व्यावहारिक बना दिया। यह इतिहास एक सबक देता है: “सबसे अच्छा” तरीका आंशिक रूप से इस सवाल पर निर्भर है कि कौन-से संसाधन मौजूद हैं। जैसे-जैसे डेटा और कंप्यूट सस्ते होते जा रहे हैं, डीप लर्निंग नए क्षेत्रों में फैलती जा रही है — लेकिन जहाँ डेटा कम है, बजट छोटे हैं, या व्याख्याएँ ज़रूरी हैं, वहाँ क्लासिक मशीन लर्निंग समझदारी भरा डिफ़ॉल्ट बनी हुई है।
छोड़ देने लायक़ आम भ्रांतियाँ
तीन ग़लतफ़हमियाँ अंतहीन उलझन पैदा करती हैं। पहली, “डीप लर्निंग हमेशा ज़्यादा सटीक होती है।” छोटे या टेबुलर डेटासेट पर अक्सर ऐसा नहीं होता — और एक मॉडल जो 1 प्रतिशत ज़्यादा सटीक है लेकिन सौ गुना ज़्यादा महँगा है, किसी भी व्यावसायिक अर्थ में बेहतर नहीं है। दूसरी, “मशीन लर्निंग और AI एक ही चीज़ हैं।” जैसा कि एक-दूसरे के अंदर रखे डिब्बों ने दिखाया, ML, AI तक पहुँचने का एक रास्ता है, पूरा नक्शा नहीं। तीसरी, “ज़्यादा डेटा का मतलब अपने आप बेहतर परिणाम होता है।” गंदा, पक्षपाती या ग़लत लेबल किया गया डेटा दोनों ख़ेमों में आत्मविश्वास से भरे ग़लत मॉडल बनाता है। डेटा की गुणवत्ता, डेटा की मात्रा को सुर्खियों के सुझाव से कहीं ज़्यादा बार मात देती है, और डेटासेट को साफ़ करना शायद ही कभी आकर्षक काम होता है — लेकिन यहीं अनुभवी विशेषज्ञ अपना ज़्यादातर समय बिताते हैं, और यहीं परियोजनाएँ चुपचाप सफल या असफल होती हैं।
अक्सर पूछे जाने वाले सवाल
क्या डीप लर्निंग, मशीन लर्निंग से बेहतर है?
हर जगह नहीं। डीप लर्निंग तस्वीरों, ऑडियो और टेक्स्ट जैसे असंरचित डेटा की बड़ी मात्रा के लिए बेहतर है। छोटे, संरचित डेटासेट के लिए, क्लासिक मशीन लर्निंग अक्सर उतनी ही सटीक होती है, साथ ही सस्ती, तेज़ और समझाने में आसान भी।
क्या डीप लर्निंग इस्तेमाल करने के लिए मुझे GPU चाहिए?
गंभीर मॉडलों को प्रशिक्षित करने के लिए, प्रभावी रूप से हाँ — GPU (या क्लाउड विकल्प) प्रशिक्षण को नाटकीय रूप से तेज़ बनाते हैं। छोटे प्रयोगों या पहले से प्रशिक्षित मॉडलों के इस्तेमाल के लिए, एक सामान्य कंप्यूटर सीखने और प्रोटोटाइप बनाने के लिए काफ़ी हो सकता है।
क्या कोई शुरुआती व्यक्ति दोनों सीख सकता है?
हाँ, और समझदारी भरा क्रम है पहले मशीन लर्निंग। इसके मूल विचार — प्रशिक्षण डेटा, फ़ीचर, ओवरफ़िटिंग, मूल्यांकन — वही नींव हैं जिन पर डीप लर्निंग खड़ी होती है। बुनियाद में महारत हासिल कीजिए, फिर गहराई में जाइए।
निष्कर्ष
मशीन लर्निंग और डीप लर्निंग प्रतिद्वंद्वी नहीं हैं; वे एक ही टूलबॉक्स के औज़ार हैं, अलग-अलग पैमानों पर। मशीन लर्निंग उस डेटा से पैटर्न सीखती है जिसे इंसान ने सावधानी से तैयार किया हो, और वह मामूली डेटा वाली संरचित समस्याओं पर चमकती है। डीप लर्निंग बड़े न्यूरल नेटवर्क का इस्तेमाल करके कच्चे डेटा से अपने फ़ीचर ख़ुद सीखती है, और वह बड़े पैमाने पर धारणा और भाषा पर चमकती है। यह समझ लीजिए कि हर एक आपसे क्या माँगता है — डेटा, हार्डवेयर और व्याख्या-योग्यता — और चुनाव आमतौर पर ख़ुद हो जाता है।