सर्च इंजन असल में कैसे काम करते हैं
सर्च बॉक्स में एक सवाल टाइप कीजिए और एक सेकंड से भी कम समय में आपको अरबों पेजों में से निकले जवाबों की एक साफ़-सुथरी सूची मिल जाती है। यह जादू जैसा लगता है, लेकिन असल में यह एक विशाल, सुव्यवस्थित प्रणाली है जो तीन चरणों में काम करती है। सर्च इंजन कैसे काम करते हैं यह समझने से आपको यह समझने में मदद मिलती है कि कुछ पेज पहले स्थान पर क्यों आते हैं, बिल्कुल नए पेजों को दिखने में समय क्यों लगता है, और सर्च परिणाम हर व्यक्ति के लिए अलग क्यों होते हैं। यह गाइड क्रॉलिंग, इंडेक्सिंग और रैंकिंग को सरल भाषा में समझाती है, बताती है कि एंटर दबाते ही सर्च इंजन आपके सवाल का जवाब कैसे देता है, और रास्ते में सबसे आम भ्रमों को भी दूर करती है।
पहला चरण: क्रॉलिंग — पेजों को खोजना
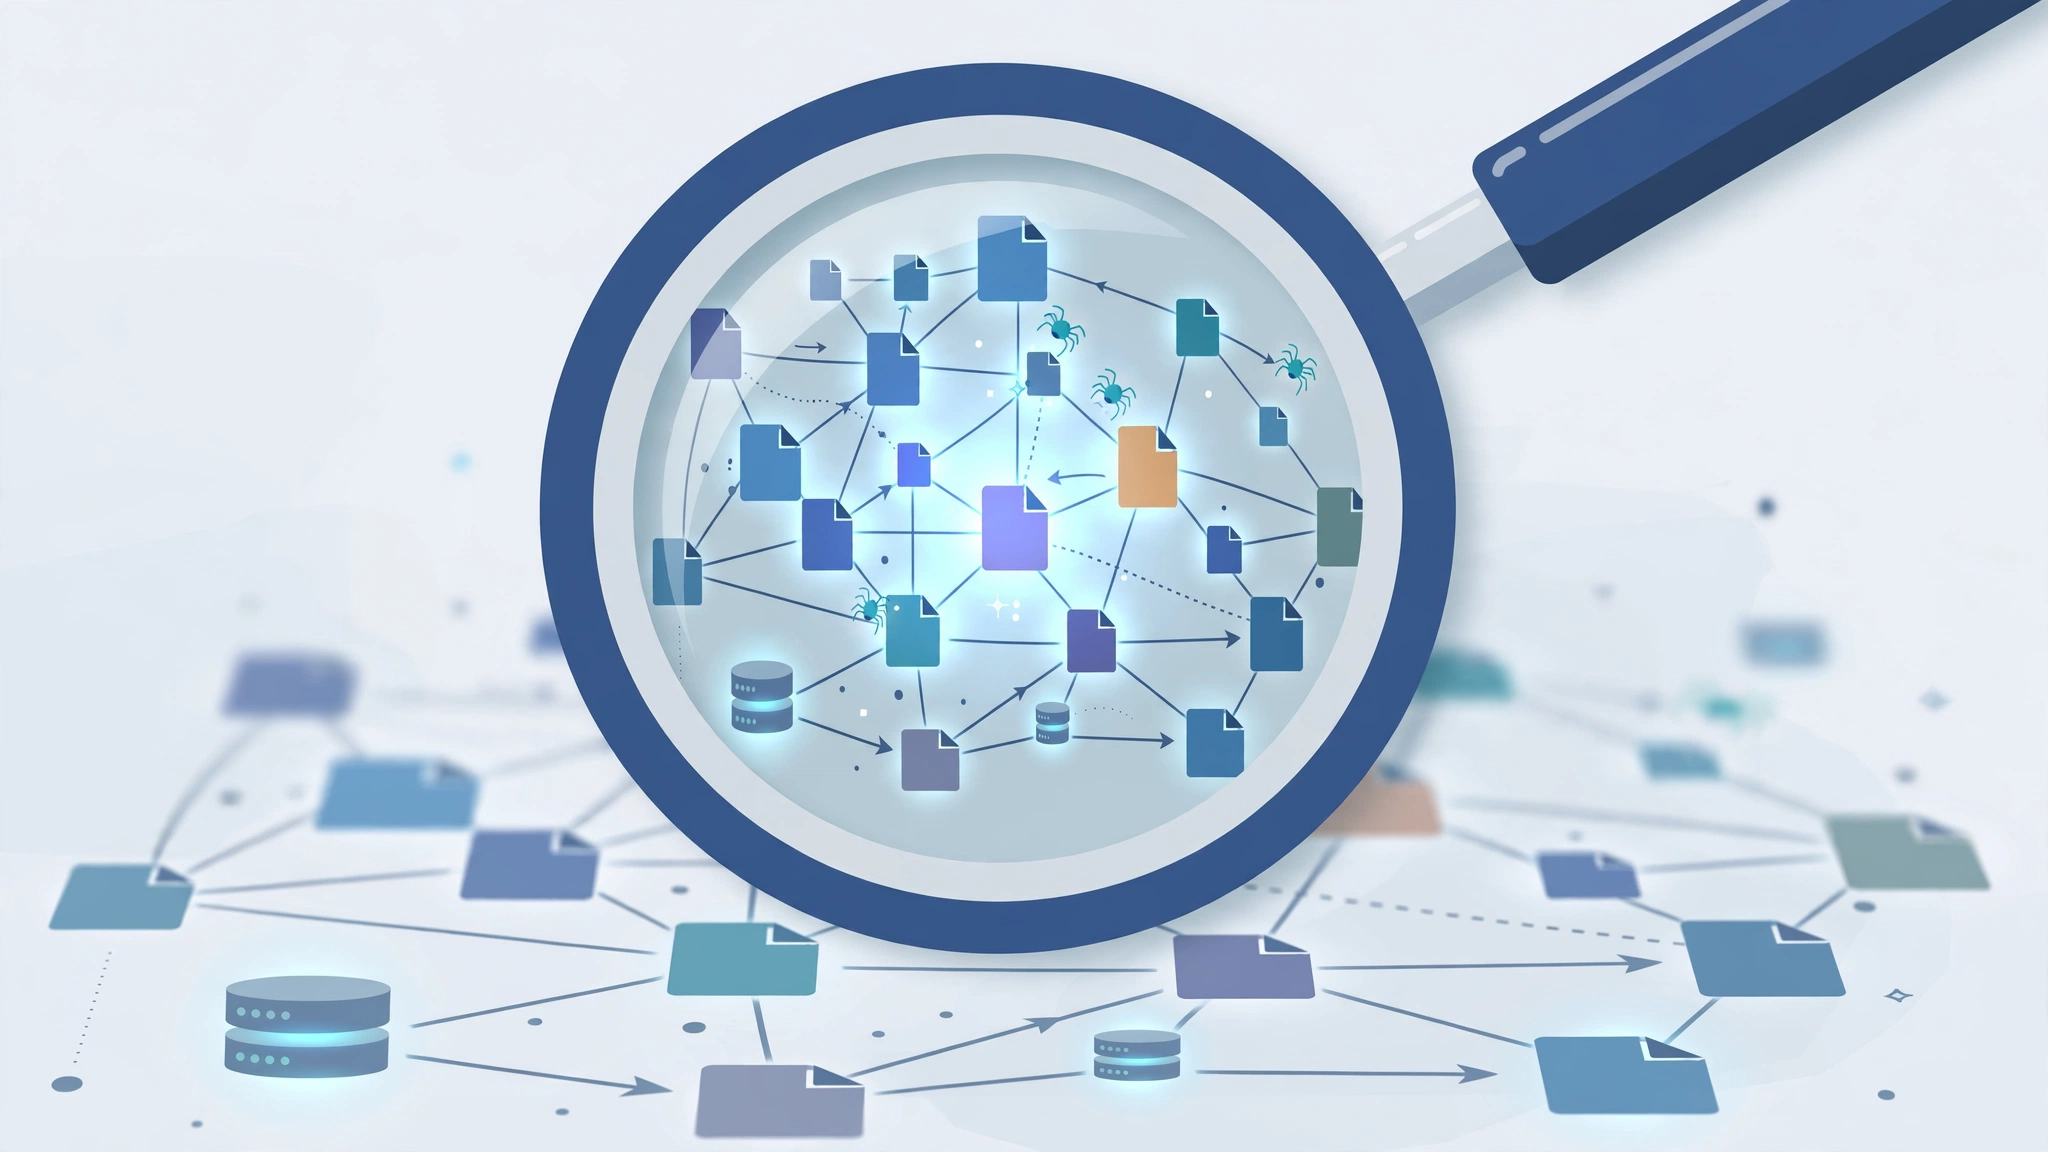
कोई सर्च इंजन किसी पेज को दिखा सके, उससे पहले उसे वह पेज मिलना चाहिए। सर्च इंजन स्वचालित प्रोग्रामों का उपयोग करते हैं जिन्हें क्रॉलर, बॉट या स्पाइडर कहा जाता है। Google का क्रॉलर Googlebot कहलाता है। एक क्रॉलर ज्ञात वेब पतों की सूची से शुरू करता है और एक पेज से दूसरे पेज तक लिंक का पीछा करता है, लगातार नए पेज खोजता रहता है और पुराने पेजों पर बदलावों की जाँच के लिए दोबारा जाता रहता है।
क्रॉलर वेब पर कैसे घूमते हैं
लिंक इंटरनेट की सड़कें हैं। जब कोई क्रॉलर किसी पेज पर जाता है, तो वह उस पेज पर मौजूद लिंक पढ़ता है और उन्हें आगे जाने वाले स्थानों की अपनी कतार में जोड़ देता है। साइट मालिक Google Search Console जैसे टूल के ज़रिए साइटमैप सबमिट करके खोज की गति बढ़ा सकते हैं — साइटमैप एक फ़ाइल होती है जो साइट के महत्वपूर्ण पेजों की सूची देती है। क्रॉलर हर पेज पर समान रूप से नहीं जाते। लोकप्रिय, बार-बार अपडेट होने वाली साइटें दिन में कई बार क्रॉल हो सकती हैं, जबकि एक छोटा, कम बदलने वाला पेज हर कुछ हफ़्तों में एक बार देखा जा सकता है। ध्यान के इस बजट को कभी-कभी क्रॉल बजट कहा जाता है, और यही एक कारण है कि बड़ी साइटें अपनी इंटरनल लिंकिंग साफ़ रखने और अपने सर्वर तेज़ रखने के लिए कड़ी मेहनत करती हैं।
क्रॉलर किन बातों का सम्मान करते हैं और क्या छोड़ देते हैं
साइट मालिक robots.txt नाम की फ़ाइल से क्रॉलरों का मार्गदर्शन करते हैं, जो बॉट को बता सकती है कि साइट के किन हिस्सों को छोड़ देना है, जैसे एडमिन पेज या डुप्लिकेट प्रिंट संस्करण। कोई पेज noindex निर्देश भी रख सकता है, जो क्रॉलिंग की अनुमति देता है लेकिन इंजन से कहता है कि पेज को परिणामों में न दिखाए। क्रॉलर लॉग इन नहीं कर सकते, ज़्यादातर फ़ॉर्म नहीं भर सकते, और पेवॉल के पीछे छिपी सामग्री नहीं देख सकते, जब तक कि मालिक पहुँच न दे — यही वजह है कि कुछ बिल्कुल अच्छे पेज सर्च में कभी दिखाई ही नहीं देते। जब कोई क्रॉलर आता है, तो वह पेज को बिल्कुल ब्राउज़र की तरह डाउनलोड करता है, जिसमें टेक्स्ट, इमेज और कोड शामिल होते हैं, और जो कुछ भी उसे मिलता है उसे अगले चरण में भेज देता है।
दूसरा चरण: इंडेक्सिंग — लाइब्रेरी बनाना
पेज मिलना काम का केवल आधा हिस्सा है। फिर सर्च इंजन को उसे समझना होता है और उसे इस तरह संग्रहीत करना होता है कि उसे तुरंत निकाला जा सके। इस भंडार को इंडेक्स कहा जाता है, और इसकी सबसे अच्छी कल्पना एक विशाल लाइब्रेरी कैटलॉग के रूप में की जा सकती है। किताबों को अलमारियों में रखने के बजाय, इंडेक्स हर पेज पर मौजूद हर महत्वपूर्ण शब्द को दर्ज करता है और यह भी कि वह कहाँ दिखाई देता है।
पेज को कैसे प्रोसेस किया जाता है
इंडेक्सिंग के दौरान, इंजन पेज को रेंडर करता है, यानी वह उसे असली ब्राउज़र की तरह लोड करता है और कोड चलाता है ताकि वह JavaScript के साथ दिखाई देने वाली सामग्री को देख सके। यह टेक्स्ट, शीर्षक, हेडिंग, इमेज और वीडियो निकालता है, और विश्लेषण करता है कि पेज किस बारे में है: उसका विषय, उसकी भाषा, उसकी स्थान-संबंधी प्रासंगिकता, और वह कितना ताज़ा है। यह लगभग-डुप्लिकेट पेजों को एक साथ समूहित भी करता है और दिखाने के लिए एक कैनोनिकल संस्करण चुनता है, ताकि तीन अलग-अलग पतों से पहुँचा जा सकने वाला एक ही लेख परिणामों में तीन बार न दिखाई दे। जो पेज हल्के, डुप्लिकेट या noindex टैग से अवरुद्ध होते हैं, वे क्रॉल तो हो सकते हैं लेकिन इंडेक्स से पूरी तरह बाहर रह जाते हैं।
इंडेक्सिंग में समय क्यों लगता है
कोई नया पेज प्रकाशित होते ही खोजने योग्य नहीं हो जाता। क्रॉलर को उसे खोजना होता है, उस पर जाना होता है, उसे प्रोसेस करना होता है और उसे इंडेक्स में जोड़ना होता है, और हर कदम में घंटे, दिन या कभी-कभी हफ़्ते लग सकते हैं। साइट मालिक महत्वपूर्ण नए पेजों के लिए इंडेक्सिंग का अनुरोध कर सकते हैं, लेकिन इंजन फिर भी ख़ुद तय करता है कि कब क्रॉल करना है और पेज जगह पाने का हक़दार है या नहीं। यह देरी कई शुरुआती लोगों को हैरान करती है, जो एक लेख प्रकाशित करते हैं और पाँच मिनट बाद उसे खोजते हैं। प्रणाली बस बेहद विशाल है: इंडेक्स में सैकड़ों अरब पेज हैं और जैसे-जैसे पेज आते, बदलते और ग़ायब होते हैं, यह लगातार फिर से बनाया जा रहा है।
तीसरा चरण: रैंकिंग — क्रम तय करना
इंडेक्स में आपके शब्दों से मेल खाने वाले लाखों पेज हो सकते हैं। रैंकिंग वह प्रक्रिया है जिससे तय होता है कि कौन से कुछ पेज शीर्ष स्थानों के हक़दार हैं। जब आप सर्च करते हैं, तो इंजन सैकड़ों संकेतों का उपयोग करके उम्मीदवार पेजों को स्कोर करता है, फिर उन्हें एक सेकंड के अंश में क्रमबद्ध कर देता है।
सबसे महत्वपूर्ण संकेत
प्रासंगिकता सबसे पहले आती है: क्या पेज सचमुच वह कवर करता है जो आपने पूछा, उतनी गहराई में जितनी आप शायद चाहते हैं? इंजन शीर्षक, हेडिंग और मुख्य भाग में मौजूद शब्दों को देखता है, लेकिन आधुनिक प्रणालियाँ सटीक मेल से कहीं आगे जाती हैं। वे पर्यायवाची शब्दों, एंटिटी और इरादे को समझती हैं, इसलिए “fix a dripping tap” की सर्च एक प्लंबिंग गाइड सामने ला सकती है जिसमें वह सटीक वाक्यांश कभी इस्तेमाल ही न हुआ हो। इसके बाद गुणवत्ता और भरोसा मायने रखते हैं। जो पेज असली विशेषज्ञता दिखाते हैं, स्रोतों का हवाला देते हैं, और जिन्हें अन्य प्रतिष्ठित साइटें लिंक के ज़रिए सुझाती हैं, वे ऊँची रैंक पाते हैं। लिंक विश्वास के वोट की तरह काम करते हैं — यह विचार Google की मूल PageRank प्रणाली से आया है जो आज भी रैंकिंग को प्रभावित करती है, हालाँकि अब कुछ मज़बूत, प्रासंगिक लिंक सैकड़ों कमज़ोर लिंकों से भारी पड़ते हैं।
उपयोगिता, ताज़गी और संदर्भ
जो पेज धीरे लोड होता है, स्क्रीन पर उछलता-कूदता है, या फ़ोन पर पढ़ा नहीं जा सकता, वह संघर्ष करेगा, क्योंकि सर्च इंजन लोडिंग गति और मोबाइल अनुकूलता जैसे असली उपयोगकर्ता अनुभव संकेतों को मापते हैं। ताज़गी तब मायने रखती है जब विषय इसकी माँग करता है: “election results” या “weather tomorrow” के परिणाम सबसे नए पेजों को तरजीह देते हैं, जबकि “how to tie shoelaces” के साथ ऐसा नहीं होता। संदर्भ बाकी सब कुछ व्यक्तिगत बनाता है। आपका स्थान, भाषा, डिवाइस और हाल का सर्च इतिहास — ये सब सूची को आकार देते हैं, यही वजह है कि अलग-अलग शहरों में मौजूद दो लोग शायद ही कभी एक जैसे परिणाम देखते हैं। तेज़ी से, सर्च इंजन AI ऑटोमेशन और मशीन लर्निंग पर बनी प्रणालियों का भी उपयोग करते हैं ताकि अस्पष्ट क्वेरी की व्याख्या की जा सके, स्पैम का पता लगाया जा सके, और केवल शब्दों का मेल करने के बजाय उनके पीछे के अर्थ को समझा जा सके।
जिस सेकंड आप सर्च करते हैं, उसमें क्या होता है
लाइब्रेरी तैयार होने के बाद, क्वेरी का जवाब देना एक खोज की दौड़ बन जाता है। इंजन आपके शब्दों की व्याख्या करता है, वर्तनी सुधारता है, पर्यायवाची फैलाता है, और इरादे का अनुमान लगाता है: क्या आप कुछ ख़रीदना चाहते हैं, कुछ सीखना चाहते हैं, किसी ख़ास साइट पर जाना चाहते हैं, या आस-पास कहीं जाना चाहते हैं? फिर वह इंडेक्स से सबसे मज़बूत उम्मीदवार पेज निकालता है, उन्हें अपनी रैंकिंग प्रणालियों से स्कोर करता है, डुप्लिकेट हटाता है, और परिणाम पेज तैयार करता है। वह पेज दस नीले लिंकों से कहीं ज़्यादा होता है। क्वेरी के आधार पर, आपको स्थानीय व्यवसायों के लिए मैप पैक, इमेज, वीडियो, शॉपिंग लिस्टिंग, किसी पेज को सीधे उद्धृत करने वाला फ़ीचर्ड स्निपेट, या कई स्रोतों का सारांश देने वाला AI-जनित अवलोकन दिखाई दे सकता है। हर तत्व इसलिए चुना जाता है क्योंकि इंजन का अनुमान है कि संतोषजनक जवाब तक पहुँचने का यही सबसे तेज़ रास्ता है।
विज्ञापनदाता ऑर्गेनिक परिणामों के साथ-साथ चलने वाली एक अलग नीलामी के ज़रिए दिखाई देते हैं। विज्ञापनों पर लेबल लगा होता है, और भुगतान करने से किसी पेज की बिना-भुगतान वाली रैंकिंग कभी बेहतर नहीं होती — यह अलगाव सर्च इंजन सावधानी से बनाए रखते हैं क्योंकि ऑर्गेनिक परिणामों में भरोसा ही उनका पूरा उत्पाद है।
सिर्फ़ Google नहीं: व्यापक सर्च दुनिया
Google ज़्यादातर देशों में सर्च का बड़ा हिस्सा संभालता है, लेकिन यह एकमात्र इंजन नहीं है। Microsoft का Bing कई अन्य सेवाओं के लिए परिणाम देता है और उसने AI-सहायता प्राप्त जवाबों में भारी निवेश किया है। DuckDuckGo उन उपयोगकर्ताओं को आकर्षित करता है जो व्यक्तिगत ट्रैकिंग के बिना परिणाम चाहते हैं। Baidu चीन में और Yandex रूस में प्रभुत्व रखता है, प्रत्येक स्थानीय भाषा और नियमों के अनुरूप ढला हुआ है। इस बीच, “सर्च” का बढ़ता हिस्सा अब अन्य ऐप के अंदर होता है: लोग Amazon पर उत्पाद, YouTube और TikTok पर वीडियो, और मैप ऐप में स्थानीय सुझाव खोजते हैं। इनमें से प्रत्येक अपने आप में एक सर्च इंजन है, जिसकी अपनी क्रॉलिंग, इंडेक्सिंग और रैंकिंग तर्क प्रणाली है, भले ही वह जिस लाइब्रेरी को खोजता है वह एक ही प्लेटफ़ॉर्म तक सीमित हो।
सर्च इंजनों के बारे में आम भ्रम
भ्रम एक: आप ऑर्गेनिक रूप से पहले स्थान पर आने के लिए भुगतान कर सकते हैं। आप नहीं कर सकते। भुगतान वाले स्थान विज्ञापन होते हैं, जो बिना-भुगतान वाले परिणामों से स्पष्ट रूप से अलग रखे जाते हैं। भ्रम दो: किसी कीवर्ड को कई बार दोहराने से रैंकिंग बढ़ती है। वह तरकीब, जिसे कीवर्ड स्टफ़िंग कहा जाता है, अब पेजों को नुक़सान पहुँचाती है; इंजन विषयों को समझते हैं, केवल शब्दों की गिनती को नहीं। भ्रम तीन: नई साइटें रैंक नहीं कर सकतीं। नई साइटें भरोसे के बिना शुरू होती हैं, लेकिन कोई केंद्रित पेज जो किसी विशिष्ट सवाल का सचमुच जवाब देता है, वह पुराने, कमज़ोर पेजों से आश्चर्यजनक रूप से जल्दी आगे निकल सकता है। भ्रम चार: कोई एक गुप्त तरकीब है। रैंकिंग प्रासंगिकता, गुणवत्ता, लिंक, उपयोगिता और संदर्भ का योग है। टिकाऊ रणनीति बेझिझक साधारण है: सचमुच मददगार पेज प्रकाशित कीजिए, असली सिफ़ारिशें कमाइए, साइट को तेज़ और क्रॉल करने में आसान रखिए, और धैर्य रखिए जब तक इंडेक्स आप पर भरोसा करना न सीख ले।
अगर आप वेबसाइट चलाते हैं तो इसका क्या मतलब है
एक बार जब आप तीनों चरण समझ जाते हैं, तो ज़्यादातर अच्छा सर्च इंजन ऑप्टिमाइज़ेशन रहस्यमय होना बंद कर देता है और सामान्य समझ बन जाता है। क्रॉलिंग के लिए, अपनी साइट को खोजना आसान बनाइए: अपने महत्वपूर्ण पेजों को मेनू से और संबंधित लेखों से लिंक कीजिए, एक साफ़ साइटमैप रखिए, और उन टूटे लिंकों को ठीक कीजिए जो क्रॉलर का समय बर्बाद करते हैं। इंडेक्सिंग के लिए, हर पेज को एक स्पष्ट विषय, एक वर्णनात्मक शीर्षक, और लाइब्रेरी में जगह पाने लायक पर्याप्त सामग्री दीजिए; हल्के पेज जो कुछ नहीं जोड़ते, वे अक्सर क्रॉल होते हैं और चुपचाप हटा दिए जाते हैं। रैंकिंग के लिए, काम धीमा लेकिन सरल है: सबसे मददगार जवाब प्रकाशित कीजिए जो आप दे सकें, उद्धृत किए जाने लायक बनकर लिंक कमाइए, पेजों को फ़ोन पर तेज़ और पठनीय रखिए, और तथ्य बदलने पर महत्वपूर्ण लेखों को अपडेट कीजिए।
एक सरल दिनचर्या जो काम करती है
हर कुछ हफ़्तों में Search Console देखिए कि कौन सी क्वेरी पहले से आपको इंप्रेशन ला रही हैं, Google ने कौन से पेज इंडेक्स किए हैं, और क्या किसी क्रॉल त्रुटि पर ध्यान देने की ज़रूरत है। नए पेज लिखने से पहले उन पेजों को बेहतर बनाइए जो शीर्ष स्थानों से ठीक नीचे रैंक करते हैं, क्योंकि वे अपनी प्रासंगिकता पहले ही साबित कर चुके हैं। अपने सबसे मज़बूत पेजों से उन पेजों की ओर इंटरनल लिंक जोड़िए जिन्हें आप ऊपर उठाना चाहते हैं। इनमें से कुछ भी कोई तरकीब नहीं है, और कुछ भी रातोंरात काम नहीं करता, लेकिन यह बढ़ता जाता है: हर मददगार पेज पूरी साइट का भरोसा मज़बूत करता है, और भरोसेमंद साइटें ज़्यादा बार क्रॉल होती हैं, ज़्यादा पूरी तरह इंडेक्स होती हैं, और ज़्यादा उदारता से रैंक पाती हैं। यही फ़ीडबैक लूप, कोई गुप्त सेटिंग नहीं, वह तरीक़ा है जिससे छोटी साइटें बड़ी बनती हैं।
अक्सर पूछे जाने वाले प्रश्न
किसी नए पेज को Google पर दिखने में कितना समय लगता है?
कुछ घंटों से लेकर कई हफ़्तों तक, कुछ भी हो सकता है। क्रॉलर को पेज खोजना होता है, उस पर जाना होता है, और उसे इंडेक्स में जोड़ना होता है। स्थापित, बार-बार क्रॉल होने वाली साइटों के पेज आमतौर पर सबसे तेज़ी से दिखाई देते हैं। साइटमैप सबमिट करना और Google Search Console में इंडेक्सिंग का अनुरोध करना खोज में मदद कर सकता है, लेकिन दोनों में से कोई भी तुरंत शामिल होने की गारंटी नहीं देता।
मेरे सर्च परिणाम किसी और के परिणामों से अलग क्यों होते हैं?
क्योंकि रैंकिंग संदर्भ का उपयोग करती है। स्थान, भाषा, डिवाइस और सर्च इतिहास — ये सब प्रभावित करते हैं कि कौन से पेज आपके लिए सबसे प्रासंगिक माने जाएँ। किसी दूसरे शहर में सर्च करने वाला व्यक्ति, या किसी दूसरे डिवाइस पर लॉग आउट होकर सर्च करने वाला व्यक्ति, अक्सर उन्हीं शब्दों के लिए स्पष्ट रूप से अलग क्रम देखेगा।
क्या कोई वेबसाइट सर्च इंजन को ख़ुद को सूचीबद्ध करने से रोक सकती है?
हाँ। robots.txt फ़ाइल क्रॉलरों को साइट के कुछ हिस्सों पर जाने से रोक सकती है, और noindex टैग इंजन को बताता है कि किसी पेज को परिणामों से बाहर रखे, भले ही वह क्रॉल हो गया हो। साइट मालिक इन टूल का उपयोग एडमिन क्षेत्रों, धन्यवाद पेजों और अन्य ऐसी सामग्री के लिए करते हैं जो आगंतुकों के लिए मौजूद होनी चाहिए लेकिन सर्च में नहीं दिखनी चाहिए।
निष्कर्ष
सर्च इंजन वेब को क्रॉल करके पेज खोजते हैं, उन्हें एक विशाल खोजने योग्य लाइब्रेरी में इंडेक्स करते हैं, और प्रासंगिकता, गुणवत्ता और संदर्भ का उपयोग करके एक पल में उनकी रैंकिंग करते हैं। एक बार जब आप प्रणाली को रहस्य के बजाय लाइब्रेरी के रूप में देखते हैं, तो दृश्यता के नियम स्पष्ट हो जाते हैं: ऐसे पेज बनाइए जो खोजे जाने लायक हों, उन्हें क्रॉल करना और समझना आसान बनाइए, और वह भरोसा कमाइए जो आपको सूची में ऊपर ले जाता है। चाहे आप सर्च कर रहे हों या प्रकाशित, यही सरल तीन-चरण वाली तस्वीर लगभग हर उस बात को समझा देती है जो आप परिणामों के ऐसे दिखने के बारे में कभी देखेंगे।